基于 SPSS 的数据资料整理与分析
基于 SPSS 的数据资料整理与分析
目前,基于 SPSS 的数据资料整理与分析的方法主要有 4 种:基于 SPSS 软件的资料描述性统计、基于 SPSS 软件的离散型资料数据整理分组与频率分布图绘制、基于 SPSS 软件的连续性资料数据整理分组与频率分布图绘制和基于 SPSS 软件的统计图形绘制。
原理
基于 SPSS 的数据资料整理与分析的基本原理是当数据量较大,无法直观地看出其分布规律时,通常需要采用分组的方式对数据资料进行整理和描述统计。离散型资料可以直接采用资料的类别或自然值进行分组,而对于类别较多的计数资料,则可以将相邻若干个自然值作为一组。
连续性资料一般采用组距分组法进行分组。分组时,首先找出资料中的最大值和最小值,求出全距;根据资料中数据多少(即样本容量)大致确定要分的组数;用全距除以组数得到组距(为了方便分组,尽可能采用整数作为组距);然后确定第一组的组下限(小于等于资料中的最小值),然后依次加上组距就得到第二组的组下限、第三组的组下限,最后一组的组上限要大于资料中的最大值。组分好后,将资料中的各个数值依次划归到各组中去,最后统计出各组的频数,列出频数分布表。频数分布表中还可以计算出各组的频率和从第一组到最后一组的累积频率。
利用 Excel 和 SPSS 软件可以较方便地对资料进行分组,列出频数分布表。根据频数分布表可以对资料的集中性和离散程度进行直观的分析。当然,更为直观的形式是利用数据资料作出统计图形。一般情况下,多采用柱形图(条形图)表示离散型资料各类别的频数(频率)分布,较少类别的分类资料可用饼图表示各类别的相对比率;而连续性资料多采用直方图显示其分布情况。Excel 和 SPSS 都有很出色的绘制统计图的功能。
对资料进行描述统计,主要采用算术平均数、几何平均数、调和平均数、中数和众数等特征值描述资料的集中性,采用全距、方差、标准差和变异系数等特征值描述资料的离散性;采用偏度和峭度等特征值体现资料与正态分布间的偏差。偏度值大于 0,分布向左偏斜;偏度值小于 0,分布向右偏斜。峭度值大于 0,资料的分布比正态分布更尖峭;峭度值小于 0,分布比正态分布更平坦。Excel 和 SPSS 软件可以同时计算出上述描述统计结果,但需要我们根据统计结果对资料的性质与分布进行解读。
操作方法
SPSS分析qPCR数据
原理
由于在 PCR 扩增的指数时期,模板的 Ct 值和该模板的起始拷贝数存在线性关系,所以该 Ct 值成为实验定量的依据。
材料与仪器
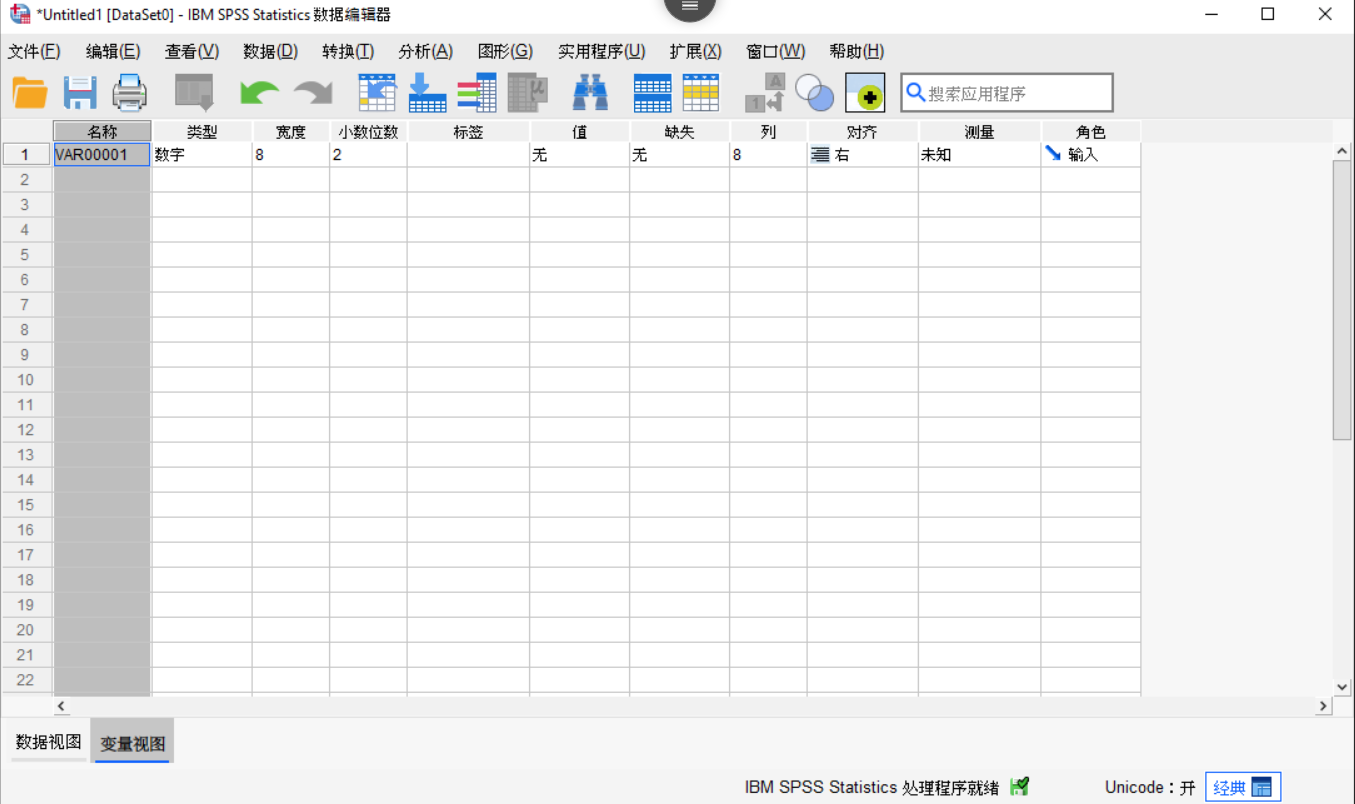
spss 软件/网页版,qPCR 数据文件 步骤 1、认识 SPSS 软件界面 SPSS 界面和普通 EXCEL 界面相似,横向可设置变量种类,纵向为具体变量数据。点击下面标签可以转换到变量视图,设置变量类型。我们直接在这个界面输入数据就行。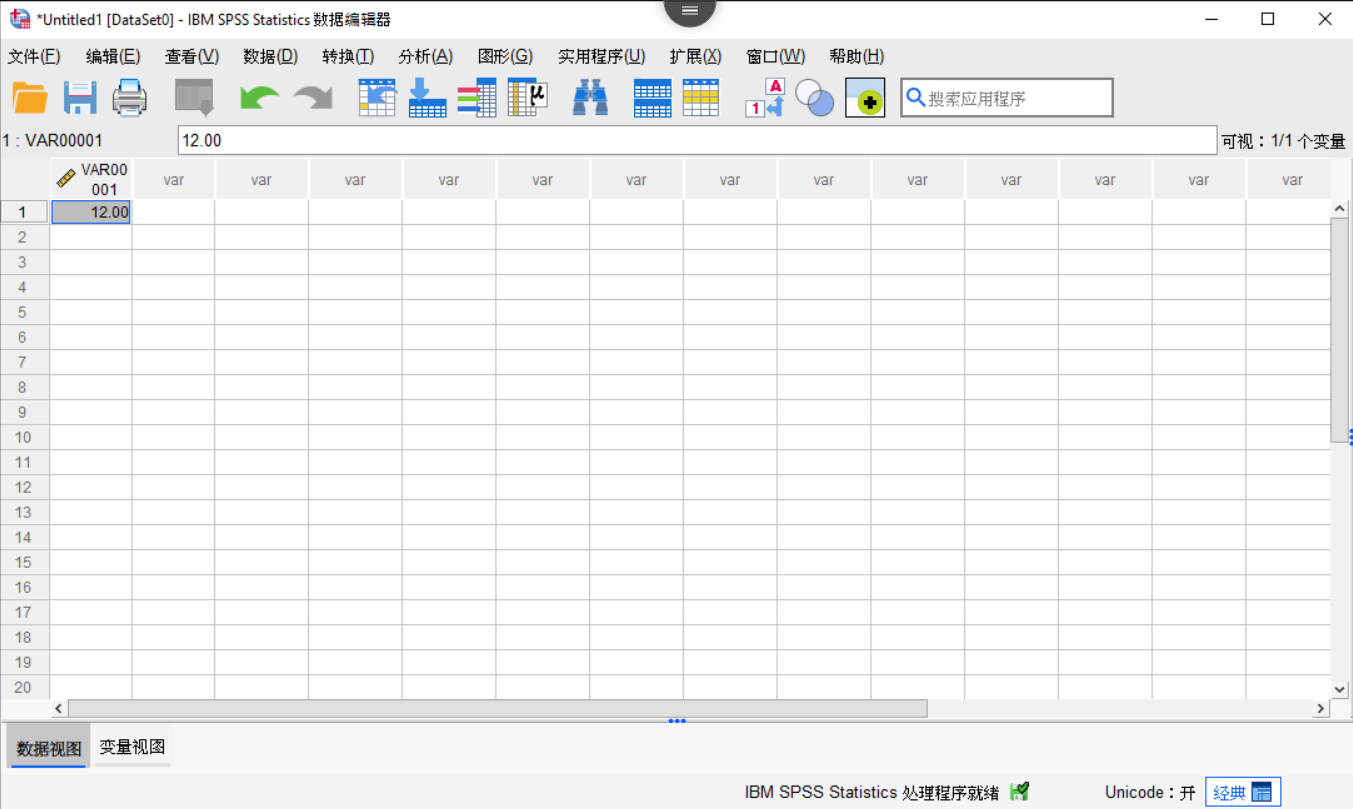
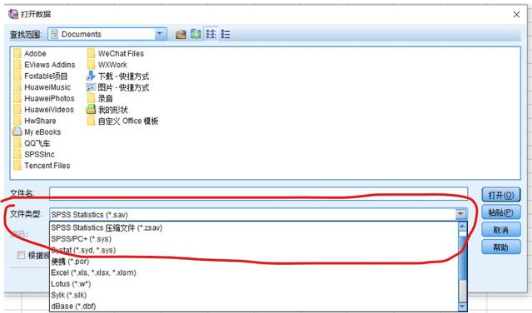
方法一:标准导入
点击:文件-打开-数据,在对话框选择你所要导入的数据文件即可。
方法二、拖拽导入
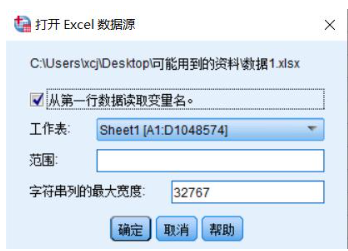
直接将数据 Excel 文件拖入 SPSS 操作页面,数据拖入后会出现如下界面,点确定即可。
对数据的均值、方差、标准差等进行计算分析。
点击:文件-分析-描述性统计-频率-勾选所需统计量

首先保证数据准确,遵守 MIQE 标准 1。下面以每组 3 个重复样本量为例说明如何统计分析。
| Group | Sample | Ct target | Ct mean of T | Ct reference | Ct mean of R |
| Control | Sample 1 | 22.89 | 22.90 | 15.29 | 15.63 |
22.82 | 15.91 | ||||
23.00 | 15.69 | ||||
Sample 2 | 22.60 | 22.64 | 15.83 | 15.60 | |
22.46 | 15.71 | ||||
22.85 | 15.27 | ||||
Sample 3 | 22.49 | 22.53 | 14.81 | 14.98 | |
22.49 | 14.79 | ||||
22.60 | 15.34 | ||||
| Experimental | Sample 1 | 25.32 | 25.31 | 14.98 | 15.18 |
| 25.40 | 15.33 | |||
| 25.20 | 15.22 | |||
| Sample 2 | 25.70 | 25.60 | 15.46 | 15.38 |
|
| 25.50 | 15.45 | ||
|
| 25.61 | 15.22 | ||
| Sample 3 | 25.49 | 25.60 | 15.25 | 15.05 |
|
| 25.68 | 14.60 | ||
|
| 25.64 | 15.29 |
该数据为两组,每组 3 个 PCR 数据。首先测出目的基因变化量(目的基因量和其对应的内参基因之比,也就是 2-△Ct),对照组同理。然后将实验组(experimental)的平均值与对照组的 2-△Ct 相比,即可得到 2-△△Ct ,也就是倍数变化(fold change)。
5、选择正确统计方法,进行差异性统计(1)t 检验是用来根据两组数据的平均值的差异来计算 p 值的。t 检验的主要假设是,两组数据是独立的,并且符合正态分布。t 检验与非参数检验相比,是最著名的非参数统计检验之一;
(2)Wilcoxon 秩和检验(有时称为 Mann-Whitney U 检验;不要与 Wilcoxon signed-rank 检验混淆,后者用于比较两个配对组)。与参数统计检验(如 t 检验)相比,有一个优势,即它们不依赖于数据是否正态分布;
(3)正态分布的 Kolmogorov-Smirnov 检验可以用来决定是应用 t 检验还是非参数检验。
6、p 值分析通常我们鼓励将 p 的具体绝对值体现在表格中,因为 p_会隐藏 p 的绝对值。而呈现真正绝对值的时候,0.032 的 p 值比 0.055 的 p 值稍有 "意义"。
注意事项
1. 变量类型设置错误。如将定性变量设置为定量变量。解决方法是根据变量的本质判断其类型,定性与定量变量要区分清楚。
2. 统计方法选择错误。没有根据数据类型和数据分布特点选择合理的统计检验方法,或是对各种参数检验背后的原理与假设没有正确理解,这会使得检验结果不合理,从而产生错误的统计推断。解决方法是系统性学习各统计检验方法的理论知识并学会正确判断选择。
3. 对 p 值的误解。将 p 值的大小本身视为组间差异或相关的大小,比如认为 p<0.01 的数据比 p<0.05 的数据组间差异更大,这个理解是错误的!这两个 p 值比较,只能得出组间差异有统计学差异,或者说前者出错的概率更低,而将 p 值高低进行比较会对 p 值产生理解误区,继而产生错误判断。解决方法是正确理解 p 值代表的检验结果的可信度或显著性水平。
4. PCR 多次实验重复后,标准曲线重合度小,实验重复性差?(1)基线设置太低影响精确度和准确度。解决方法是手动设置基线,基线终止值(End)设置在信号上升之前。
(2)加样误差,比如制备 PCR 反应液时没有完全混匀,导致加样时每个孔成分不同。解决方法是在分装反应液之前,要将反应液充分混匀(振荡,吹打)。同时上机之前,要将 PCR 管或者 PCR 板离心,使所有的液体都在反应管底部。
(3)低拷贝的样品,泊松分布若 A 管(30 μL)中有 9 个模板,则均匀分配 10 μL 到 B、C、D 管中时,每管 3 个模板的概率不相同。这个误差没有很好的解决办法。
如需了解更多产品详情,请前往阿拉丁官网查询。


 危险品化学品经营许可证(带存储)